
理解扩散模型,重点是分清模型预测什么、采样器怎样使用预测,以及潜空间和网络结构如何影响计算成本。本文沿 DDPM、DDIM、Stable Diffusion、DiT 与 Flow Matching 展开,保留关键公式和模型结构,用直觉解释设计目的。
扩散模型:从加噪直觉到现代生成模型
在扩散模型广泛用于图像生成之前,GAN(生成对抗网络)已经是一条重要路线:生成器从随机噪声出发,一次前向计算就生成图片;判别器则学习区分真实图片和生成图片,推动生成器改进。但这种对抗训练不容易保持平衡:判别器可能很快抓住生成图片的破绽,强到让生成器难以获得有效的改进信号;生成器也可能找到少数能骗过判别器的结果,即使输入不同噪声,仍反复生成相似图片,无法覆盖数据的多样性,这称为“模式坍塌”。
扩散模型把从噪声生成图像的任务拆成许多小步。阅读时可以沿着三件事走:训练时怎样构造监督,网络输出代表什么,推理时怎样用这个输出更新图像。
代码仅用于表达模型结构和采样算法,省略导入、数据准备和运行脚本。张量采用 PyTorch 约定,图像形状写为 [B,C,H,W]。
1.扩散概率模型:先把生成问题拆成小步
2015 年,Sohl-Dickstein 等人提出了一种生成模型:先把数据逐步扰动成容易采样的简单分布,再学习这个过程的反向转移。原论文
给手写数字加少量噪声,笔画仍然可辨认,相邻两步之间只发生很小的变化。直接描述所有数字的分布很困难,但可以学习这些小变化,再将许多次反向变化组合成生成过程。
1.1 从加噪到图像生成
以 MNIST 为例,持续加噪会让不同数字的笔画逐渐消失,最后都接近高斯噪声。生成时从一份新噪声开始,模型逐步形成图像结构。学习的目标是让生成结果符合数字图像的分布,并不需要为这份新噪声找回一张唯一的原图。
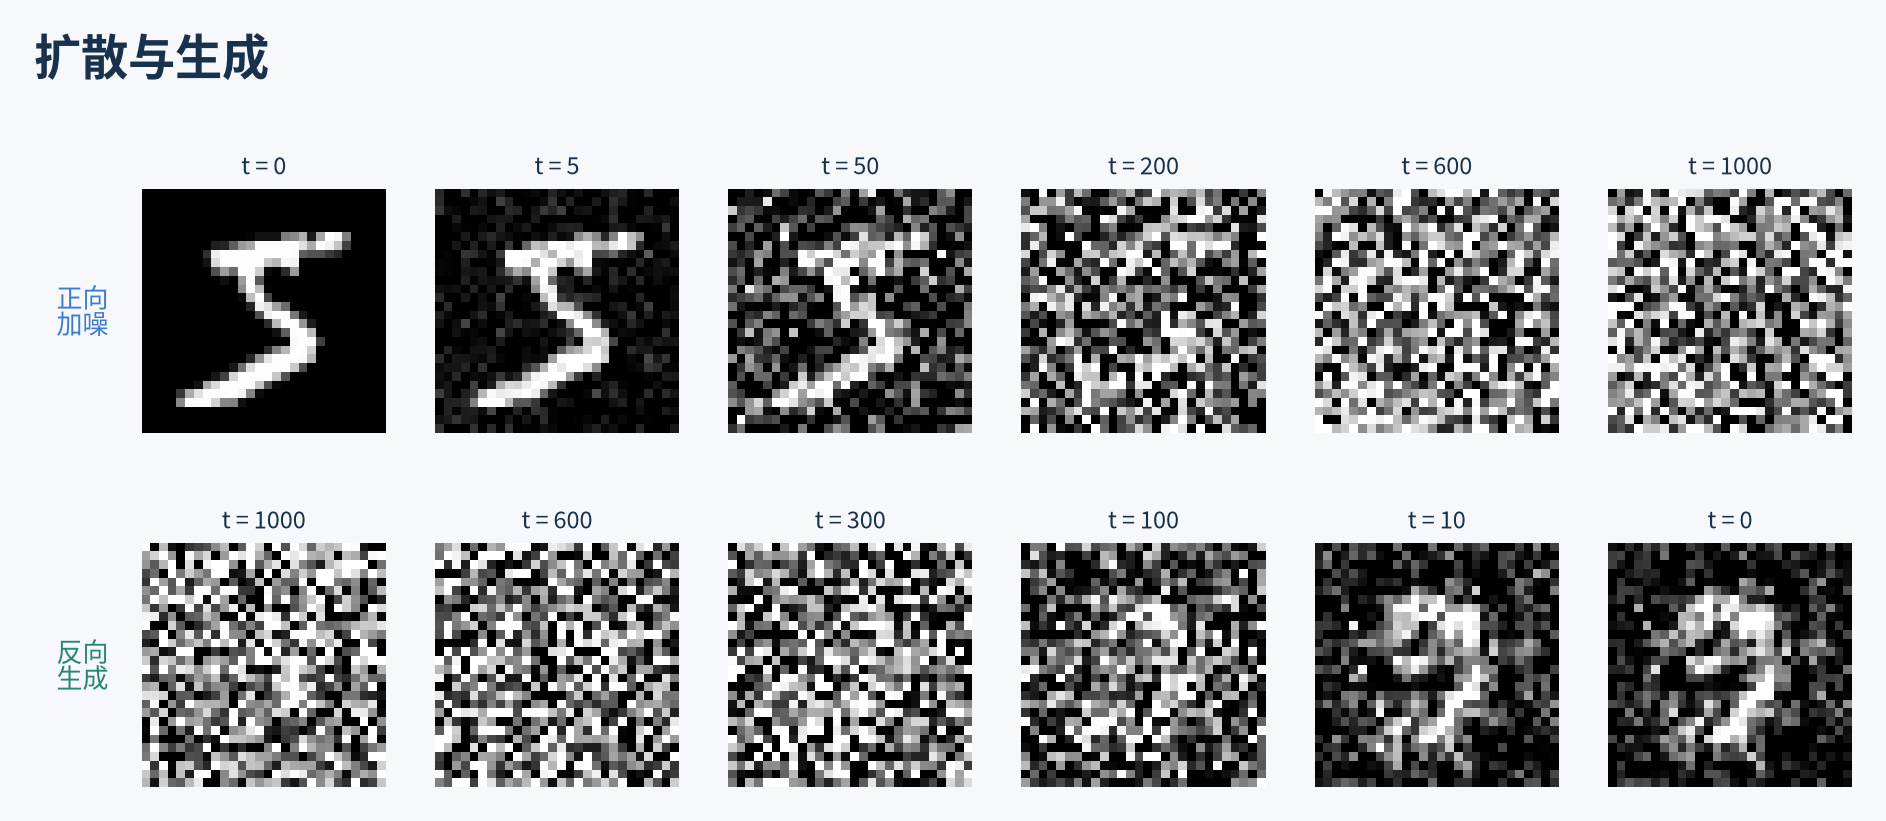
上排是一张图片的加噪过程;下排是模型从另一份噪声开始生成的轨迹。每一步都根据当前状态和时间做预测,然后由采样器计算下一步状态。
1.2 为什么加噪时还要削弱原图?
如果只是不断往原图上叠加独立高斯噪声,得到的分布仍以原图为中心,方差却不断增大。我们希望不同图片最终都接近同一种容易采样的分布,因此每次加噪还会削弱已有信号:
平方根来自一个简单事实:把随机量乘以一个系数,方差会乘以这个系数的平方。 上面的两个系数让旧信号逐渐衰减,同时控制噪声尺度;如果输入已经是标准高斯噪声,输出仍是标准高斯噪声。
多次加噪还可以合并成一次计算:
记
这让训练很方便:可以直接抽一个时间点,为原图构造对应的带噪输入,无需先执行前面所有加噪步骤。“合并”指得到相同的条件分布,不要求两种计算产生同一份噪声。
推理步数则由反向采样方法决定。正向过程能直接计算任意时间点,并不意味着反向生成可以随意删掉步骤;DDIM 等方法会根据实际选取的时间点重新计算更新。
1.3 模型从哪里获得“往回走”的监督?
训练时既知道原图,也知道加噪规则,因此可以计算:给定原图和当前带噪状态,前一步状态应当服从怎样的分布。模型只接收带噪状态和时间,学习预测这个反向变化。
原始概率框架用 KL 散度等项比较目标分布与模型分布。这里把 KL 理解为衡量两个概率分布差异的量即可:相同时为零,差异越小越好。对于固定方差的高斯分布,训练均值可以化成平方误差回归。
推理时没有原图提供答案,只能反复使用学到的网络。下一章的 DDPM 把监督进一步组织成“预测加入的噪声”,使训练目标更直接。
2.DDPM:让网络预测噪声
2020 年,Ho 等人提出 DDPM,沿用逐步加噪与反向生成的框架,通过噪声预测参数化和简化训练目标改善图像生成。DDPM
2.1 输入、输出和训练目标
一次训练只需要三个动作:取原图
预测噪声和预测反向均值可以相互换算。但 DDPM 使用的简单噪声 MSE 还省去了原变分目标里随时间变化的权重,因此也改变了不同噪声程度对训练的相对影响。
2.2 时间条件 U-Net
下面的小型 U-Net 用来展示结构,输入和输出都是 [B,1,28,28]。时间编码告诉网络当前有多嘈杂;下采样提取更大范围的特征,跳跃连接把高分辨率信息交给上采样路径。
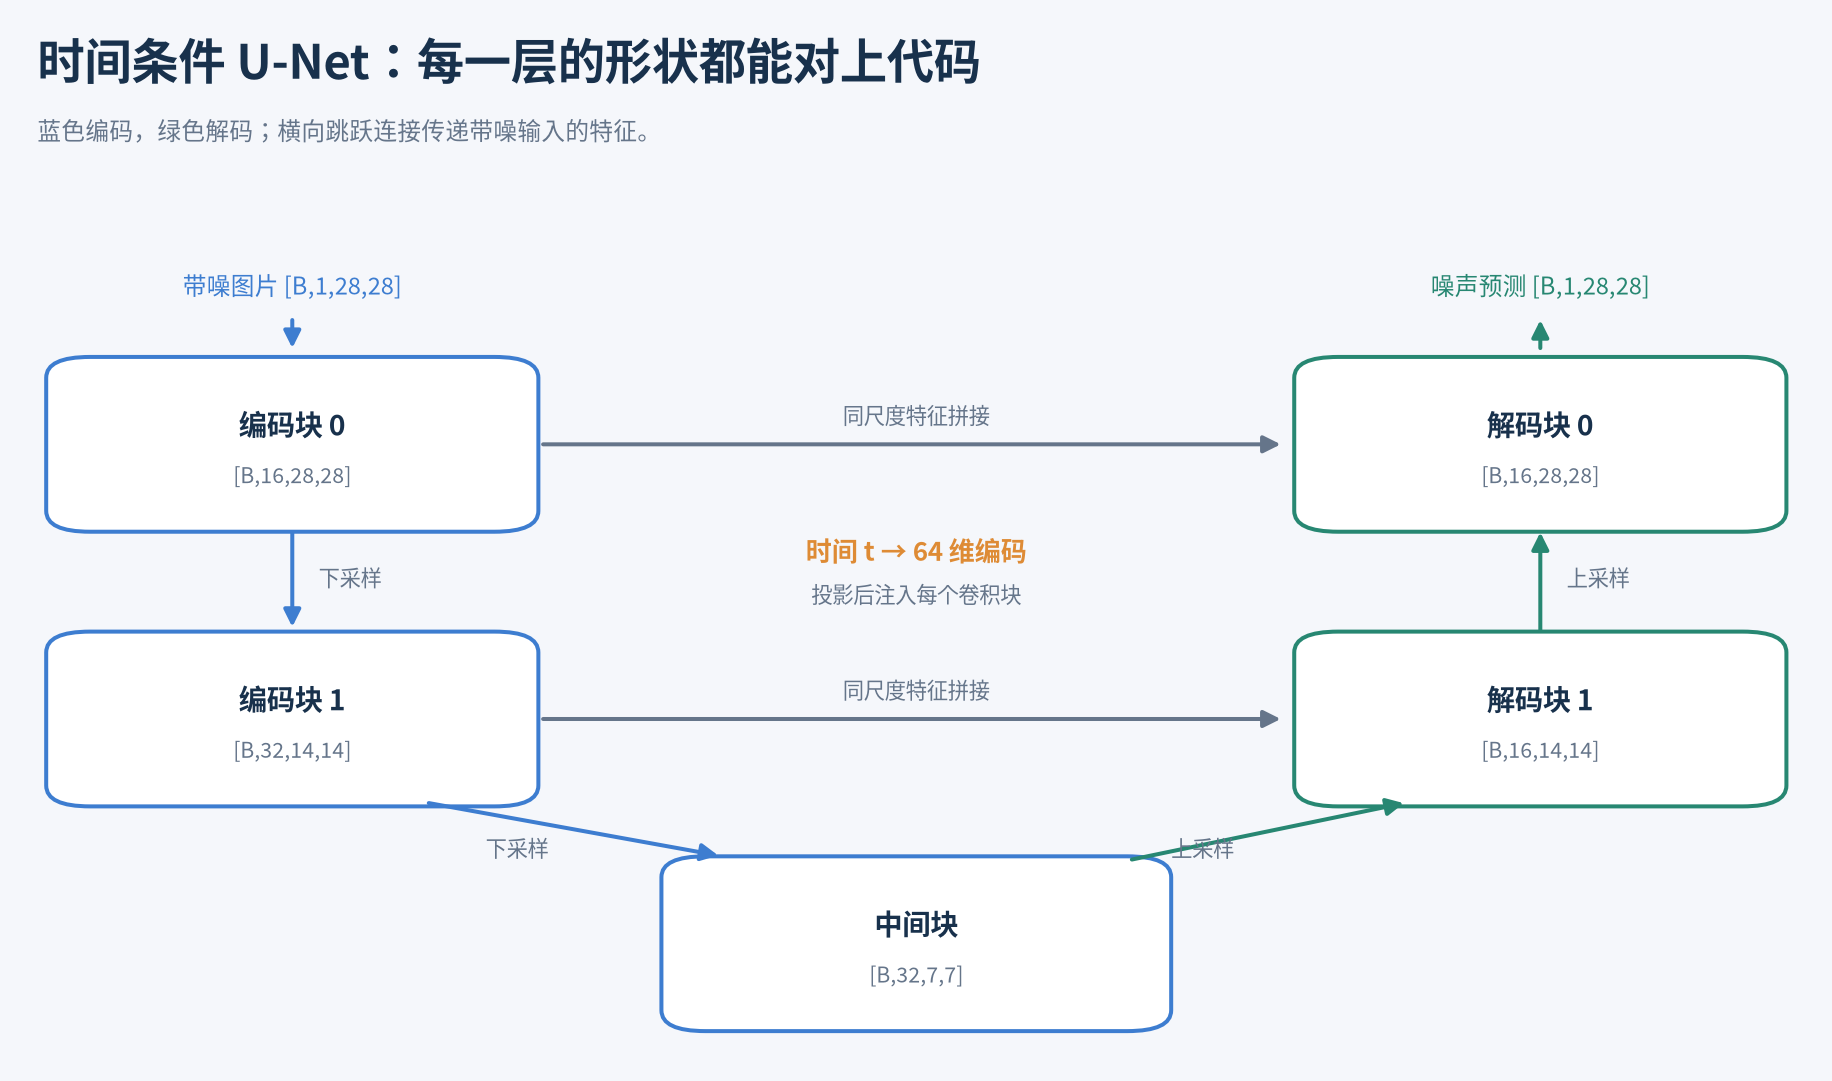
time_embedding 将每张图的时间编码成 64 维向量,通常使用不同频率的 sin/cos 编码和线性层。下面保留条件注入与特征连接的定义,省略该通用编码模块的实现。
1 | class Block(nn.Module): |
网络需要利用整张带噪图的结构来估计噪声。虽然输出逐像素排列,各位置的预测并不互相独立。U-Net 是一种骨干选择,噪声预测目标也可以配合后文的 Transformer。
2.3 采样器怎样使用噪声预测?
采样从标准高斯噪声
第一部分利用噪声预测计算下一步的中心,第二部分加入本步采样噪声。
网络负责预测,采样器负责更新状态。 网络输出噪声,并不等于直接输出下一张图。阅读实现时,要把 model(x,t) 与 scheduler.step(...) 两部分一起看。
2.4 Noise schedule 改了什么?
Noise schedule 决定信号和噪声随时间如何混合。例如,线性
需要区分三个选择:加噪日程定义各时间对应的噪声程度,推理时间网格决定生成经过哪些时间点,采样更新规则决定怎样从一个时间点走到另一个。实现中它们可能都封装在 scheduler 里,但作用不同。
已训练的网络适应了特定噪声程度与时间编码的关系。推理时可以通过兼容的采样器减少时间点,不能任意换掉加噪系数,却仍把相同时间标签交给模型。
3.Score:噪声预测也能表示生成方向
2019 年的 NCSN 从另一角度处理生成:学习不同噪声程度下,怎样移动当前状态能让它更像来自数据分布。NCSN
3.1 什么是 score?
可以把某一噪声程度下的图像分布想成高维空间里的地形:更容易出现的带噪图像,概率密度更高。Score 是当前位置沿哪个方向移动,会让对数概率密度增长最快;它是与图像同形状的方向向量。
对于前面的高斯加噪方式,噪声预测与 score 有直接联系:
模型不知道带噪图唯一对应哪张原图。许多原图和噪声组合都可能产生相似输入,它学到的是这些可能性下的平均预测,因此能提供分布层面的方向。
3.2 为什么也能用确定性过程生成?
Score SDE 把这些方法放进连续时间框架:可以用持续带随机扰动的过程生成,也可以构造只沿方向场移动的 probability-flow ODE。Score SDE
ODE 在这里可以理解为“当前状态和时间决定移动速度,沿时间不断更新”。给定初始噪声后,确定性求解器不必在每一步再采样噪声。
在精确 score 和相应数学条件下,两种过程可以具有相同的时间分布,而单个样本走过的路径不同。实际模型和数值求解都有误差,减少步数仍可能改变生成质量。这个视角为后面的采样器和速度场方法建立联系。
4.DDIM:复用预测器,减少模型调用
DDPM 逐步生成需要反复调用网络。DDIM 保留与 DDPM 相同的加噪边缘分布和训练目标,改变采样过程,使已有噪声预测器可以沿更稀疏的时间网格生成,通常不需要重新训练。DDIM
4.1 先估计原图,再走到更早的时间
由当前带噪图和噪声预测,可以估计干净图像:
确定性 DDIM 再用
4.2 核心更新
下面只保留确定性 DDIM。times 是选定的严格递减时间列表,最后包含干净端点 0;abar[t] 对应训练使用的累计系数,abar[0]=1。predict_noise(x,t) 封装模型调用,包括把标量时间整理为 batch 输入。
1 | def sample_ddim(predict_noise, x, times, abar): |
这里没有每一步新加的随机项,也没有对图像估计做裁剪。给定相同初始噪声和确定性的模型计算,轨迹便确定。DDIM 也有通过
跳步时,更新必须使用实际目标时间 prev 的系数。仅仅减少循环次数、却继续使用相邻步
把 1000 次网络调用改成 50 次,可以显著减少去噪计算,但不保证端到端恰好快 20 倍,也不保证质量不变。更少调用意味着更粗的路径近似;后续求解器通过不同更新规则和时间点选择,改善有限调用次数下的精度。
讨论“20 步生成”时,还要区分训练时间点数量、推理更新次数和实际模型评估次数。某些求解器一次更新会评估模型多次,CFG 也会增加预测的计算量。
5.CFG 与 Latent Diffusion:控制内容,降低生成成本
5.1 条件怎样进入网络?
如果希望指定生成数字 7,就需要把类别作为额外条件交给模型。对前面的 U-Net,可以将类别 embedding 加到时间 embedding 上,再送入各层;文生图则使用文本编码器产生的表示。
训练时仍然让网络预测加入的噪声。类别或文本负责告诉模型要生成什么,监督目标仍是噪声,而非分类标签。条件能力需要通过训练获得,给无条件模型多传一个标签并不能直接控制内容。
5.2 Classifier-Free Guidance:放大条件的影响
CFG(Classifier-Free Guidance,无分类器引导)让文本条件更强地影响生成结果。训练去噪网络时,会以一定概率把描述替换为空文本,让同一网络同时学会“有文本条件”和“无文本条件”的噪声预测。
生成时,在每一个去噪步骤,将同一份带噪 latent 和同一个时间点分别配上目标文本、空文本,得到两份预测
两份预测的差值表示文本条件带来的影响;
每步的两份预测可以拼成一个更大的 batch 来运行,但仍有两份样本的计算和中间激活开销,会影响延迟和显存。后文的 guidance distillation 则可以把引导效果训练进模型。
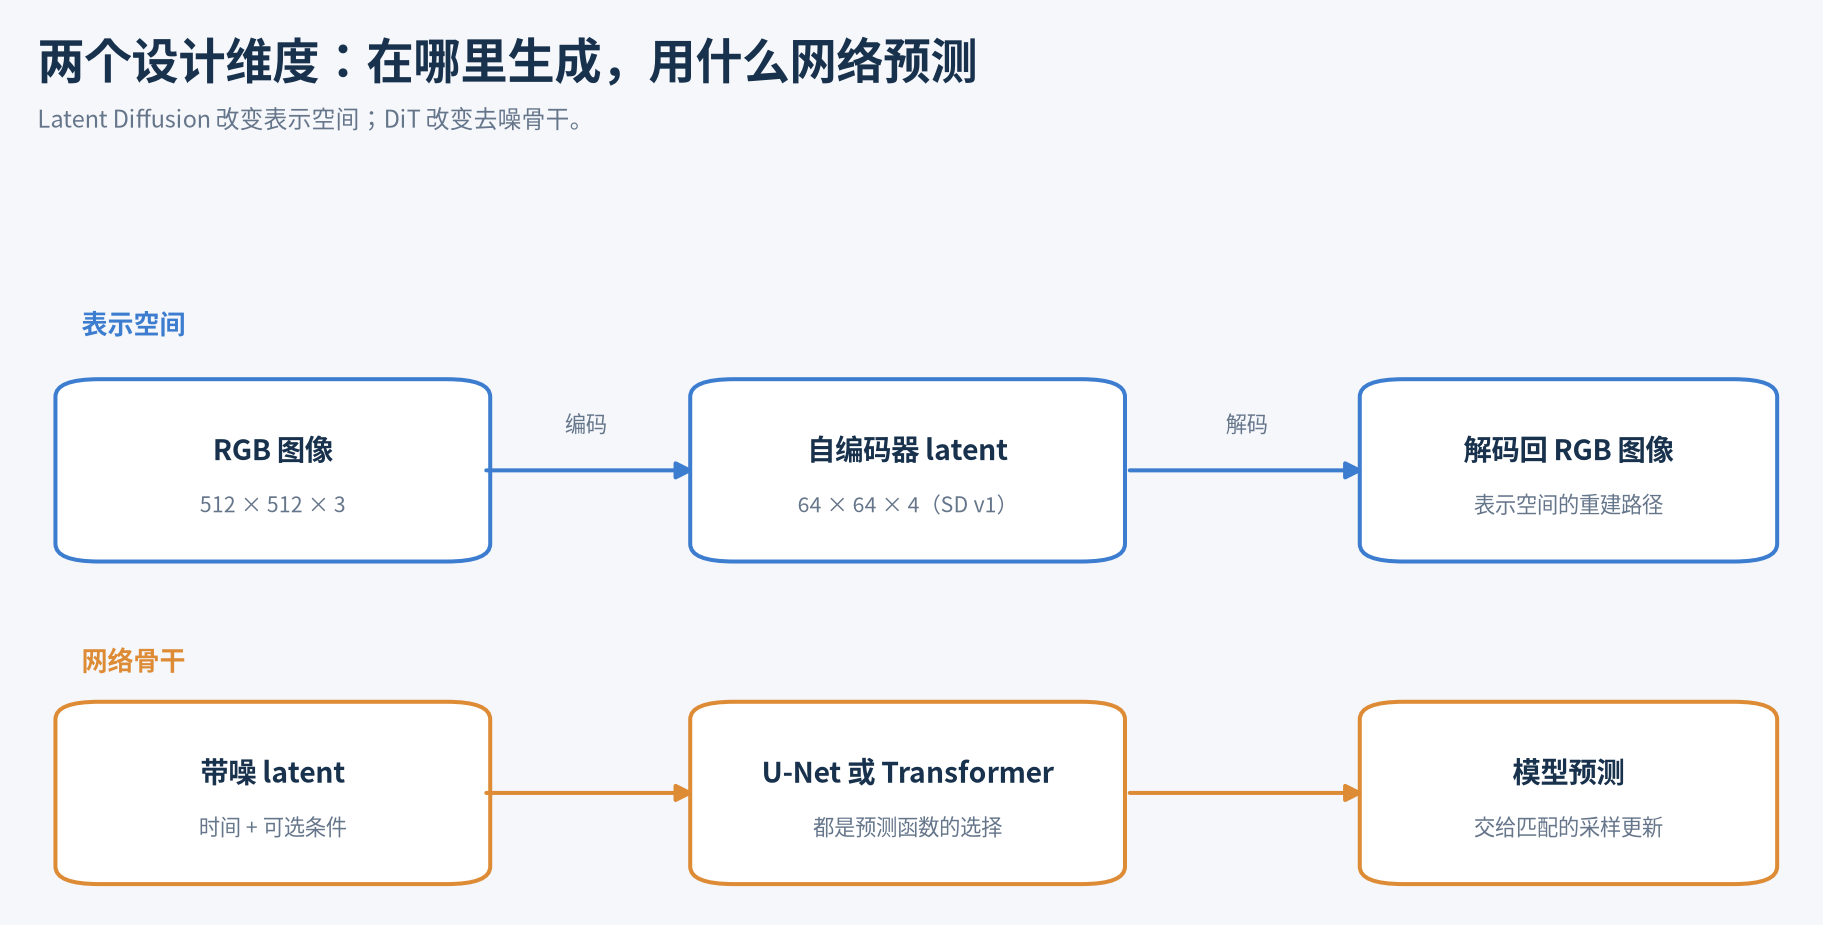
5.3 为什么到潜空间里生成?
从
加噪与噪声预测的思路可以沿用,只是输入从像素变成压缩表示。压缩降低了计算成本,自编码器的重建能力也限制了最终能保留多少细节。
5.4 先训练 VAE,再训练去噪网络
以 Stable Diffusion v1 为例,训练分为两个阶段。首先共同训练 VAE 的 encoder(编码器)和 decoder(解码器):编码器把图片压缩成 latent,解码器再将 latent 还原成图片,通过比较重建结果与原图来改进两者。这个阶段学习的是如何压缩和重建图片。
随后固定 encoder 和 decoder 的权重,训练去噪网络。先用编码器得到原图的 latent,随机选择一个噪声程度,再加入已知的高斯噪声。去噪网络接收带噪 latent、时间和文本条件,预测加入的噪声,以预测与真实噪声之间的误差作为训练信号。每次更新只需抽取一个时间点,不必完整执行多步去噪;这个阶段通常也不需要调用 decoder。LDM
5.5 Stable Diffusion v1 的组件分工
Stable Diffusion v1 使用空间压缩因子 8、4 通道的自编码器 latent,配合 U-Net 和 CLIP 文本编码器。以
生成时,所有模型权重都已固定:从随机 latent 噪声出发,反复调用去噪网络和采样器,得到符合文本条件的 latent,最后由 decoder 将它还原成图片。因此,VAE 负责图像与 latent 之间的转换,去噪网络负责学习如何生成这样的 latent。
1 | 训练准备:图片 [B,3,512,512] → VAE encoder → latent [B,4,64,64] |
下面的伪代码只展示条件分支;使用 CFG 时,每一步的噪声预测需按 5.2 节组合条件与无条件两份预测。
1 | # 1. 文本只编码一次,之后每一步去噪都会使用 |
文生图时没有待编码的目标图片;图像 encoder 用于训练准备或图生图等输入路径。
U-Net 中的 cross-attention 以图像特征产生 query,以文本表示产生 key/value,让不同空间位置读取相关文字信息。相比单个类别 embedding,文本条件能表达更丰富的内容与关系。
实际模型还约定了 latent 的缩放方式,读入和解码时都要遵守对应配置。空间位置从
6.DiT:把去噪骨干换成 Transformer
DiT 在 latent diffusion 中用 Transformer 替换 U-Net。原始工作研究的是类别条件图像生成,核心变化是网络怎样计算预测;扩散目标与采样器仍可沿用。DiT
6.1 从 latent 到 token
以原始 DiT 的
1 | 带噪 latent → patchify / projection → 加入位置信息 |
这里有三个独立的尺寸:VAE 压缩因子决定 latent 的空间大小,patch 大小决定 token 数,hidden size 决定每个 token 的特征宽度。
6.2 时间和类别怎样影响 DiT block?
原始 DiT 的 adaLN-Zero 用时间和类别条件生成归一化后的偏移、缩放,以及残差支路的门控。以下保留一个 block 的核心数据流,condition 是合并后的条件向量,modulation 输出六组 [B,D] 参数:
1 | def forward(self, x, condition): # x: [B,N,D] |
Attention 与 MLP 各有一组调制和门控。Zero 指产生这些调制参数的末层采用零初始化,使初始残差支路的贡献为零,随后通过训练逐步学出条件影响。DiT 模型实现
6.3 哪些结构决定计算成本?
patch 越小,token 越多。保持 latent 尺寸不变,把 patch 边长减半,会让 token 数变成 4 倍,标准 dense attention 中的 token 两两交互项变成 16 倍。投影和 MLP 还有各自的成本,全模型延迟需要结合实际算子与硬件判断。
因此,latent 分辨率、patch 大小、层数和隐藏维度都影响推理成本。模型最终预测噪声、方差相关参数还是速度,则由训练配置决定;看到 Transformer 骨干还不能确定采样器该怎样解释输出。
7.Flow Matching:直接学习移动速度
7.1 从噪声到数据构造一条路径
前面的 DDPM 把数据放在
随机取一张图片
随着
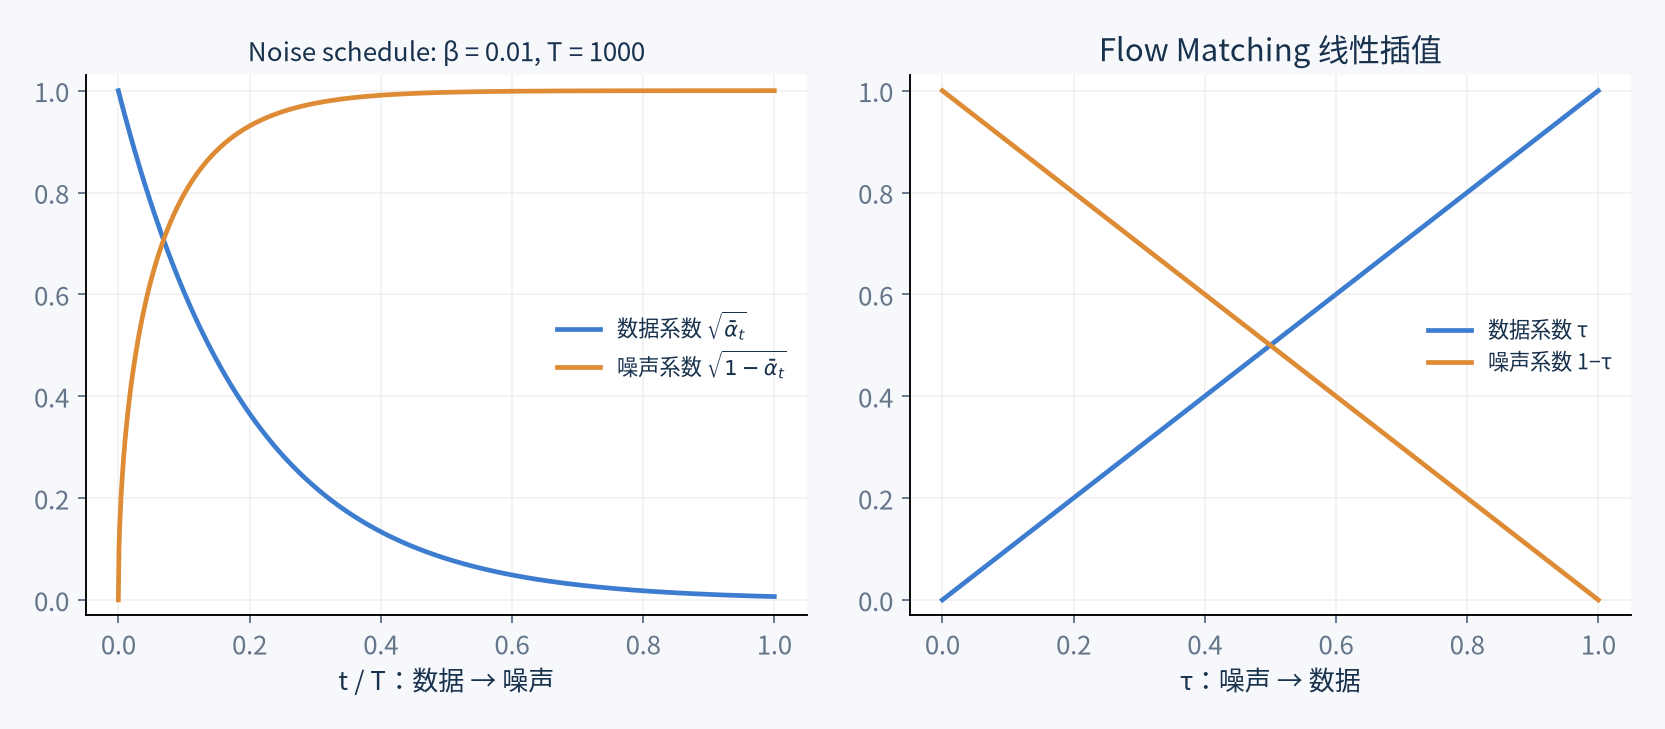
左图以固定
7.2 生成时沿速度更新
推理仍从一份新噪声开始。最简单的 Euler 方法是:查询当前速度,再用“速度乘时间间隔”更新位置。
1 | def sample_flow(predict_velocity, x, times): |
这里的 times 从 0 递增到 1;predict_velocity 接收当前状态和连续时间,返回同形状的速度预测。模型训练与推理使用相同的时间约定。
有些模型采用相反方向,例如 SD3 把数据放在 0、噪声放在 1,训练目标相应为
DDPM 的噪声预测不能直接当成本节的速度。路径和监督目标已经改变,复用骨干结构时也需要按新的目标训练。
7.3 为什么直线插值不保证一步生成?
网络输入只有当前位置和时间,不知道训练时配对的是哪张图、哪份噪声。不同配对会提供不同方向,平方误差训练让它学到当前位置下的平均速度。
生成时,每走一步都会在新位置重新预测,方向也可能改变。因此,训练端点之间的插值是直线,不代表生成轨迹也是直线;沿起点速度走一大步未必能到达好的图像。
Flow Matching 是更一般的路径与速度学习框架,上面的线性插值是其中一个具体选择。Rectified Flow 还研究 reflow:先用已有流生成新的噪声与数据配对,再训练新的流,促使轨迹更直、更适合少步求解。Rectified Flow
少步能力需要结合路径、模型误差、求解器,以及是否使用 reflow 或蒸馏来看。换成速度预测目标本身不保证一步生成。
8.SD3 与 FLUX.1:把这些设计组合起来
8.1 SD3:速度预测与多模态 Transformer
SD3 将 latent 上的 rectified-flow 速度回归与 MMDiT 结合起来。图像和文本保留各自的处理参数,并在 attention 中联合交互;相比图像 query 读取文本 key/value 的 cross-attention,这种组织允许两种模态互相更新表示。SD3
它还研究训练时间点的采样分布,例如 logit-normal,来调整不同噪声区间获得多少训练关注。这里的时间采样决定损失在哪里计算;推理时间网格与求解器则决定生成怎样推进,二者作用于不同阶段。
对推理而言,需要一起确认文本编码器、latent 表示、MMDiT 输入组织和速度输出的约定,才能串起完整生成流程。
8.2 FLUX.1:双流、单流与蒸馏变体
FLUX.1 的公开模型采用 rectified-flow Transformer。图像与文本先经过各自的双流 blocks,再拼接成序列经过单流 blocks。公开实现将 latent 的
不同变体的推理方式还受蒸馏影响:
| 变体 | 关键机制 | 推理时要区分的行为 |
|---|---|---|
| FLUX.1-dev | Guidance distillation | 将 guidance 值作为模型条件,不能据此推断每步都执行普通 CFG 的条件/无条件双预测 |
| FLUX.1-schnell | Latent adversarial diffusion distillation | 支持 1–4 步生成;少步能力属于该蒸馏变体 |
因此,两者不能仅凭相似的模型接口就共用步数与 guidance 设置,应按各自模型说明使用。dev 模型卡 schnell 模型卡
8.3 怎样判断一个模型为什么更快?
先拆开看:模型评估多少次,每次处理多少 latent tokens,骨干有多大,是否计算额外 guidance 分支,文本编码与 VAE 又各花多少时间。
更少的采样步骤通常减少去噪计算,但更大的分辨率、模型和条件分支可能增加单次成本。比较模型时,应同时看生成质量、实际模型计算量和端到端延迟。
9.阅读新模型时的技术地图
这些工作改变的是不同层面,可以组合使用:
| 工作 | 主要改变 | 对推理的意义 |
|---|---|---|
| DDPM | 噪声预测与训练目标 | 输出要经过采样器换算成状态更新 |
| Score 方法 | 用分布的方向场理解生成 | 连接随机采样与确定性 ODE |
| DDIM | 采样轨迹与时间网格 | 可以复用预测器,减少模型调用 |
| CFG | 条件与无条件预测的组合 | 增强条件影响,也增加计算 |
| Latent Diffusion | 生成所在的表示空间 | 在较小表示上迭代,最后解码 |
| DiT | Transformer 去噪骨干 | 关注 token 数、隐藏维度和层数 |
| Flow Matching/Rectified Flow | 路径与速度监督 | 按正确时间方向积分速度场 |
| SD3/FLUX.1 | 多模态骨干、路径及变体相关训练设计 | 联合核对条件、输出、采样和蒸馏约定 |
面对一个新模型,可以依次检查:
- 在哪里生成? 像素、图像 latent,还是视频等其他表示?
- 网络预测什么? 噪声、干净数据、score,还是速度?
- 监督怎样构造? 时间与噪声怎样对应,是否经过蒸馏?
- 输出怎样被使用? 采样器、时间方向、步数与 guidance 如何组合?
- 计算主要花在哪里? 网络评估次数、token 数、条件分支,以及编码和解码成本各是多少?
如果希望继续连接到服务系统,可阅读 vLLM-Omni Diffusion Runtime。本文 scheduler 决定数值状态怎样更新,服务调度器决定请求何时进入执行。
参考资料与选读
- 动画演示:扩散模型 DDPM 全解析。
- 概率框架与训练目标:2015 原始论文、DDPM 的第 2、3 节与附录 A。包含变分目标、后验和噪声参数化的推导;Improved DDPM 讨论 noise schedule 与反向方差的改进。
- 采样与连续时间视角:DDIM 讨论确定性及带随机项的采样;NCSN、Score SDE 解释 score 与生成过程的联系。
- 条件与模型结构:CFG、Latent Diffusion、DiT,以及 Stable Diffusion v1 实现、DiT 模型代码。
- 速度场与现代模型:Flow Matching、Rectified Flow 解释路径、速度监督和分布输送;SD3、FLUX.1 模型实现 展示系统组合。
原实验 Notebook 保留独立实验记录,内容与本文精简后的代码不逐段对应。第一章的过程图来自原均值模型实验,用于展示加噪与生成的直觉。